Hur funkar det
Från ett foto till en 3D-mugg på ett par sekunder, utan att fotot lämnar datorn.
Allt sker i webbläsaren: en liten tränad modell skär ut muggen, en passning läser formen och kameravinkeln, och muggen byggs och ritas i 3D med fotots tryck runt om. Här är hur, och med vilka siffror.
Steg för steg
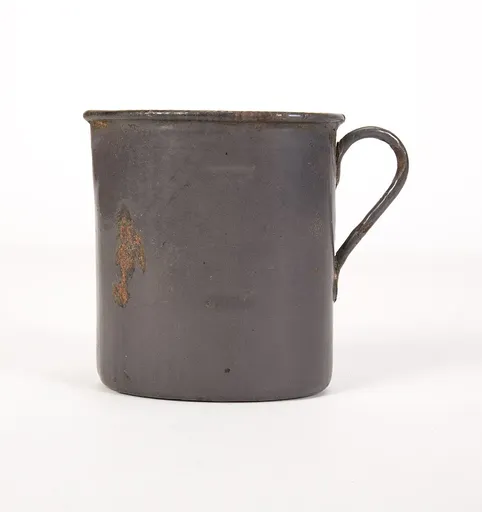
1Fotot
Fotot avkodas i en bakgrundstråd (en web worker), rätt vänt, i två storlekar: en liten att läsa och en större för trycket. Sidan själv gör nästan inget, så den hackar aldrig.
960 × 1 019 pixlar in, läses i 482 × 512.
web workerImageBitmap
2Utskärningen
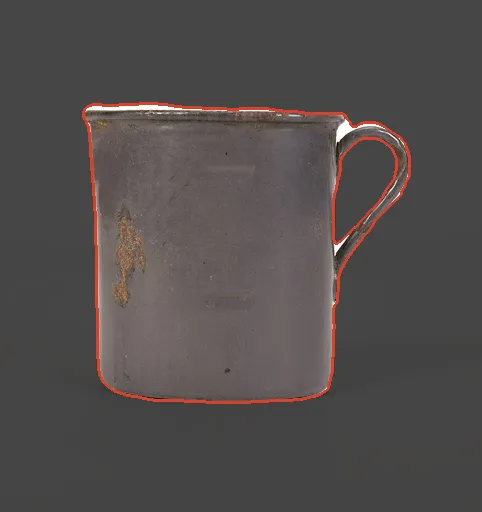
En egen liten modell markerar muggens pixlar. Den börjar som MobileNetV3-Small, ett nätverk som lärt sig känna igen 1 000 sorters saker på foton. Vi behåller bara dess första steg, sätter på en egen lätt avkodare och tränar om alltihop på muggar: från 1 000 svar till ett enda, mugg eller inte, för varje pixel. Den körs på grafikkortet med WebGPU där webbläsaren har det, på några hundradels sekunder, och annars i vanlig JavaScript med exakt samma svar. Utan något ramverk, och den funkar offline.
73 653 av 246 784 pixlar är mugg (29,8 %).
Originalet Vår modell Parametrar 2 542 856 201 377 7,9 % av originalet Storlek 9,8 MB 787 kB Svarar på vilken av 1 000 saker ett foto visar mugg eller inte, för varje pixel Bild in 224 × 224 256 × 256 Lager 13 steg och en klassificerare de 9 första stegen och en egen avkodare (13 585 parametrar) MobileNetV3-Small201 377 parametrar787 kBWebGPUJavaScript som reserv
3Formen
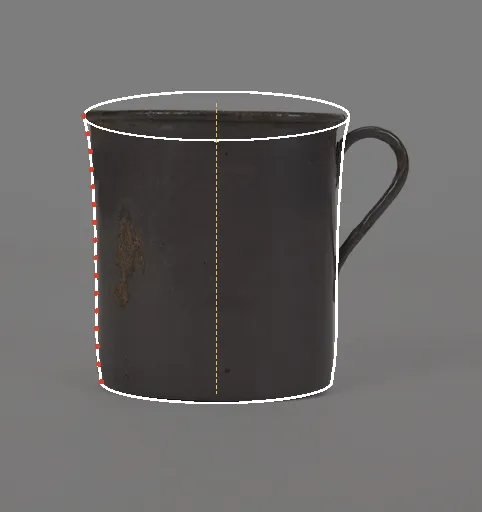
Formen läses genom att rita: en gissad profil och kameravinkel ger en kontur, som jämförs med fotots och rättas tills de stämmer (analys genom syntes). Profilen är 16 radier från botten till kanten; vinkeln söks på ett grovt rutnät och förfinas med gyllene snittet. På väg in: en tränad läsmodell (MobileNetV3-Small) som gissar vinkel, profil och handtag i ett svep, så att passningen bara behöver putsa, och som känner igen foton tagna uppifrån.
Kameran lutar 10,6°. Den passade muggens kontur ligger i snitt 0,9 % av höjden från fotots.
analys genom syntes16 profilpunktergyllene snittetläsmodell (testas)
4Handtaget
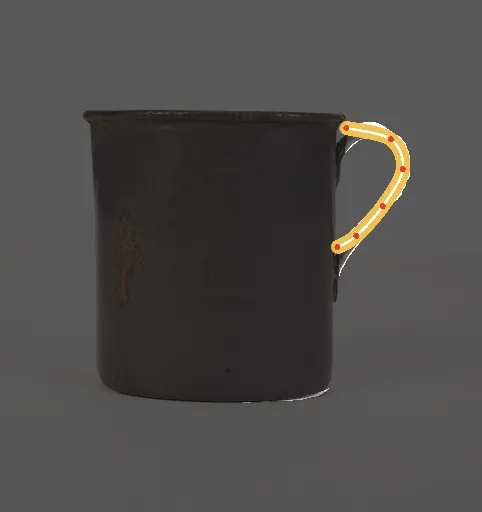
Handtaget passas som en jämn kurva med tjocklek, mot pixlarna bredvid kroppen, så att också tunna och vikta handtag blir hela.
Ett handtag format som öra, beskrivet med 6 punkter.
parametrisk kurva
53D-modellen
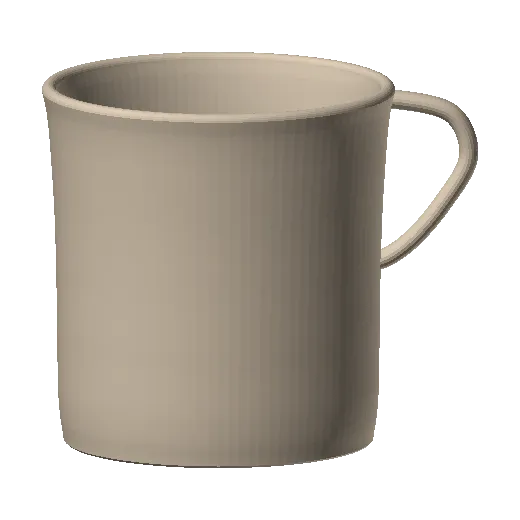
Kroppens tvärsnitt svarvas runt axeln och handtaget sveps som ett rör längs sin kurva, direkt till det som ritas, på några hundradels sekunder. Skuggningen räknas en gång längs profilen (kroppen är rund) och delas runt om. Den går att ladda ner som GLB.
36 024 trianglar, 80 × 65 × 67 mm.
svarvad ytaskuggning längs profilenGLB
6Visningen
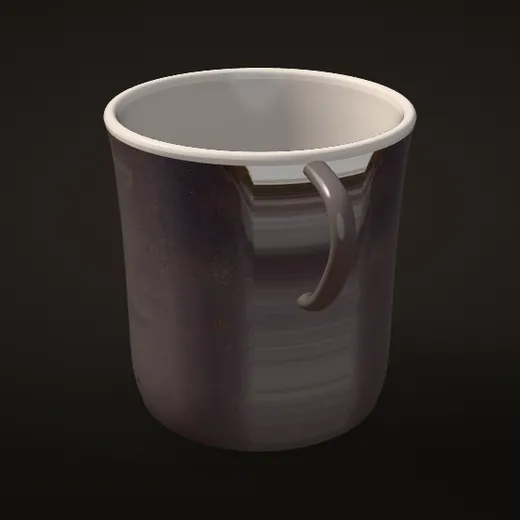
Muggen ritas med WebGL direkt: glasyr, inbakad skuggning (strålar mot muggens exakta form), en mjuk skugga på bordet och fotots tryck runt om. Inget 3D-bibliotek, så sidan är liten och snabb.
WebGL 2inbakad skuggningegna shaders
Exempelfoto: Metallmugg, handtag till höger, upphovsperson anges inte på Commons, CC BY 4.0.
Träningen
Det här finns att träna på, och modellen tränas här, på en Mac (Apple M3, PyTorch på MPS). Varje bild som används är granskad, och varje körning loggas med tid.
| Antal | Om | |
|---|---|---|
| Riktiga foton, Wikimedia Commons | 287 av 627 | Fritt licensierade. En lärarmodell (BiRefNet) ritar masken; sedan granskas den. |
| Riktiga foton, Openverse | 73 av 295 | Hittade med sökfrågor som DeepSeek skrev, sållade och maskade som ovan; licens per foto. |
| Riktiga foton, LVIS | 51 av 97 | Muggar ritade av människor (LVIS, CC BY 4.0) på foton med fri licens. |
| Syntetiska foton | 6 000 | Renderade muggar med exakta masker, bland saker och delvis skymda, mot riktiga bakgrunder och i studio. |
| Granskningar | 1 018 | DeepSeek v4.1 flash tittar på varje mask och säger ja eller nej; alla anrop bokförs. |
Modellen som appen använder nu, och vad just den tränades på:
| Inställning | Värde |
|---|---|
| Modell i appen | v1-pipeline |
| Tränad på | 93 riktiga foton |
| Träningssteg × batch | 2 000 × 32 |
| Varv genom de riktiga fotona | 688 |
| Inlärningstakt | 0,003 |
| Träningstid | 88 min |
| Förstärkning | skala, beskärning, spegling, färg, oskärpa, brus, mugg på ny bakgrund |
Läsmodellen
Läsmodellen lär sig formen och kameran ur de syntetiska fotona, där svaret är exakt känt: vinkeln, var botten och kanten hamnar i bilden, profilen och handtagets kurva. Masken den får skadas med flit under träningen, så att den klarar en ofullständig utskärning. Den prövas på riggfotona, där vinkel och form är uppmätta. Som jämförelse missar passningen vinkeln med ±9,2° och profilen med 9,3 % där, och känner inte igen något foto taget uppifrån.
| Körning | Vinkelfel | Profilfel | Uppifrån |
|---|---|---|---|
| r1 | ±3,1° | 9,5 % | 3 av 3 |
| r212 000 steg | ±3,6° | 16,7 % | 3 av 3 |
Hur bra är det?
Vi mäter mot guldmuggar: 25 riktiga foton med kontrollerade masker, och 23 foton från en kalibrerad rigg där formen och kameravinkeln är exakt kända (5 3D-skannade muggar). En ny modell tas bara in om den blir bättre.
Allt vi har prövat på guldmuggarna, senaste mätningen av varje. Facitmasken visar hur bra formläsningen är när utskärningen är perfekt; skillnaden mot appen är vad utskärningen kostar.
| Sätt att läsa | Lästa | IoU |
|---|---|---|
| Appen idag: utskärningsmodellen, sedan passningen | 24 av 25 | 86,6 % |
| Utskärningsmodell v1-pipeline, sedan passningen | 21 av 25 | 77,9 % |
| Utskärningsmodell v2a-synth, sedan passningen | 21 av 25 | 78,4 % |
| Utskärningsmodell v2b-reviewed, sedan passningen | 21 av 25 | 77,2 % |
| Utskärning v1-pipeline, läsmodellen reading-r1 gissar vinkeln, passningen putsar (±8°) | 21 av 25 | 78,1 % |
| Passningen på facitmasken | 24 av 25 | 91,3 % |
| Facitmasken, läsmodellen reading-r1 gissar vinkeln, passningen putsar (±8°) | 24 av 25 | 91,5 % |
| Facitmasken, läsmodellen reading-r1 ensam (ingen passning) | 24 av 25 | 72,7 % |
| Utan modell: egna utskärningar efter färg och kanter | 12 av 25 | 40,7 % |
Vad det har kostat i tokens
Varje anrop till en språkmodell bokförs med exakt de siffror leverantören skickade tillbaka, i en hashkedjad liggare som bara kan växa. Inget är uppskattat. Från 26 oktober 2026 till 27 oktober 2026 kl. 12:49:
| Modell | Anrop | Tokens |
|---|---|---|
| Claude Opus 5.5Skrev appen, träningen och den här sidan | 1 883 | 720,7 milj. |
| DeepSeek v4.1 flashSållade och granskade träningsbilderna | 1 615 | 4,2 milj. |
Nästan allt Claude Opus 5.5 läser är samtalet hittills: varje anrop läser om det från en cache, vilket är snabbare och billigare än att läsa det på nytt. Det som faktiskt skrevs är en liten del.
| Slag | Tokens |
|---|---|
| Nytt in (frågor, filer, svar från verktyg) | 5,1 milj. |
| Återläst ur cachen | 713,7 milj. |
| Skrivet (kod, text, verktygsanrop) | 2,0 milj. |
| – varav tänkande | 708 210 |
DeepSeek per uppgift:
| Uppgift | Anrop | Tokens |
|---|---|---|
| Granska masker | 1 018 | 3,4 milj. |
| Sålla nya foton | 593 | 759 302 |
| Prov av uppkopplingen | 3 | 6 853 |
| Skriva sökfrågor | 1 | 4 325 |
Storlek
| Del | På disk | Komprimerad |
|---|---|---|
| All kod (sidan och bakgrundstråden) | 175 kB | 65 kB |
| Utskärningsmodellen | 792 kB | 739 kB |
| Typsnitt (Instrument Serif) | 38 kB | 38 kB |
| Exempelfoton | 541 kB | 540 kB |
Källor och licenser
Exempelfotona
- Muminmugg, ränder: Angellsen, CC BY-SA 4.0
- Metallmugg, handtag till höger: upphovsperson anges inte på Commons, CC BY 4.0
- Muminmugg, Mumintrollet: OulunPooki5131, CC BY-SA 4.0
- Emaljmugg, blå bakgrund: upphovsperson anges inte på Commons, CC BY 4.0
- Metallmugg, handtag till vänster: upphovsperson anges inte på Commons, CC BY 4.0
- Avsmalnande metallmugg: upphovsperson anges inte på Commons, CC BY 4.0
- Emaljmugg med tryck: Joostik, CC0
- Vit emaljmugg: knoe, CC BY 3.0
Mumin-illustrationer © Moomin Characters; visas här bara för lokal testning.
Träning och mätning
- Foton från Wikimedia Commons (CC0, public domain, CC BY, CC BY-SA), med källa per foto.
- Foton via Openverse, med licens och källa per foto.
- LVIS (CC BY 4.0) på COCO-foton från Flickr med fri licens.
- YCB och Google Scanned Objects (CC BY 4.0): 3D-skannade muggar och riggfoton.
Byggt med
- Instrument Serif (SIL OFL 1.1), PyTorch och torchvision (BSD-3) för träningen, MobileNetV3-Small (ImageNet-vikter, BSD-3) i båda modellerna, BiRefNet lite (MIT) som lärare för maskerna.